معرفی
همزمانی (Concurrency) به توانایی یک برنامه برای مدیریت چندین وظیفه (Task) بهصورت همزمان اشاره دارد و باعث بهبود عملکرد و پاسخدهی (Responsiveness) میشود. این مفهوم شامل مدلهای مختلفی مثل ریسمانسازی (Threading)، وظایف ناهمزمان (Asynchronous Tasks) و چندپردازشی (Multiprocessing) است که هرکدام مزایا و محدودیتهای خاص خودشان را دارند. در پایتون، ریسمانها (Threads) و وظایف ناهمزمان (Asynchronous Tasks) امکان همزمانی (Concurrency) روی یک پردازنده را فراهم میکنند، درحالیکه چندپردازشی (Multiprocessing) با استفاده از چندین هستهی CPU امکان موازیسازی (Parallelism) واقعی را ایجاد میکند.
درک همزمانی (Concurrency) برای بهینهسازی برنامهها ـ مخصوصاً برنامههای وابسته به ورودی/خروجی (I/O-bound) یا وابسته به پردازنده (CPU-bound) ـ ضروری است. مدیریت صحیح همزمانی (Concurrency) میتواند با کاهش زمانهای انتظار و استفاده بهتر از منابع سیستم، عملکرد یک برنامه را بهطور چشمگیری افزایش دهد.
در این آموزش، شما یاد خواهید گرفت که:
- اشکال مختلف همزمانی (concurrency) در پایتون را درک کنید
- راهحلهای چندریسمانی (multi-threaded) و ناهمزمان (asynchronous) را برای وظایف وابسته به ورودی/خروجی (I/O-bound tasks) پیادهسازی کنید
- از چندپردازشی (multiprocessing) برای وظایف وابسته به پردازنده (CPU-bound tasks) استفاده کنید تا موازیسازی (parallelism) واقعی حاصل شود
- بر اساس نیازهای برنامهتان، مدل مناسب همزمانی (concurrency) را انتخاب کنید
برای بهرهبرداری کامل از این آموزش، باید با اصول پایهی پایتون، از جمله توابع و حلقهها، آشنا باشید. همچنین داشتن درک ابتدایی از فرآیندهای سیستم و عملکرد CPU نیز مفید خواهد بود.
بررسی همزمانی (Concurrency) در پایتون
در این بخش، با اصطلاحات مرتبط با همزمانی (Concurrency) آشنا خواهید شد. همچنین خواهید فهمید که همزمانی میتواند بسته به مسألهای که قرار است حل کند، شکلهای مختلفی داشته باشد. در نهایت، خواهید دید که مدلهای مختلف همزمانی چگونه در پایتون پیادهسازی میشوند.
همزمانی (Concurrency) چیست؟
تعریف دیکشنری از همزمانی (Concurrency) «رخداد همزمان» است. در پایتون، چیزهایی که بهطور همزمان رخ میدهند با نامهای مختلفی شناخته میشوند، از جمله:
- ریسمان (Thread)
- وظیفه (Task)
- فرآیند (Process)
در سطح کلی، همه آنها به یک دنباله از دستورات که به ترتیب اجرا میشوند اشاره دارند. میتوانید آنها را مانند خطوط فکری مختلف در نظر بگیرید. هرکدام میتوانند در نقاط مشخصی متوقف شوند و CPU یا مغزی که آنها را پردازش میکند میتواند به خط فکری دیگری سوئیچ کند. وضعیت هر خط فکری ذخیره میشود تا بتوان آن را دقیقاً از جایی که متوقف شده بود، از سر گرفت.
ممکن است از خود بپرسید چرا پایتون برای یک مفهوم واحد از کلمات مختلف استفاده میکند. در واقع، ریسمانها (Threads)، وظایف (Tasks) و فرآیندها (Processes) تنها وقتی یکسان به نظر میرسند که از دید سطح بالا به آنها نگاه کنید. وقتی به جزئیات بپردازید، خواهید دید که هرکدام نمایانگر چیزهای کمی متفاوت هستند. با پیش رفتن در مثالها، تفاوتهای آنها برایتان روشنتر خواهد شد.
حال، به بخش «همزمان» تعریف توجه میکنیم. باید کمی محتاط باشید، زیرا وقتی به جزئیات نگاه کنید، متوجه میشود که تنها چندین فرآیند سیستم (multiple system processes) هستند که میتوانند در پایتون این خطوط فکری را واقعاً بهطور همزمان (literally at the same time) اجرا کنند.
در شیوههای مختلف، ریسمانها (threads)، وظایف ناهمزمان (tasks) یا فرآیندها (processes) هرکدام به شکل متفاوتی نوبت اجرا را جابهجا میکنند. در یک رویکرد چندریسمانی (multi-threaded)، سیستمعامل واقعاً از هر ریسمان آگاه است و میتواند هر زمان آن را قطع کرده و ریسمان دیگری را اجرا کند. همین سازوکار برای فرآیندها نیز وجود دارد. این مدل را چندوظیفهای پیشدستانه (preemptive multitasking) مینامند، چون سیستمعامل میتواند بهصورت پیشدستانه ریسمان یا فرآیند شما را متوقف کند تا به دیگری سوئیچ کند.
چندوظیفهای پیشدستانه یک مزیت مهم دارد: کدی که داخل یک ریسمان اجرا میشود مجبور نیست کار خاصی برای اجازهی سوئیچ انجام دهد. اما همین موضوع میتواند دردسرساز هم باشد، بهخاطر آن عبارت «هر زمان». منظور این است که سوئیچ میتواند حتی در میانهی اجرای یک دستور پایتون اتفاق بیفتد؛ حتی در یک دستور ساده مثل:
x = x + 1در مقابل، وظایف ناهمزمان (asynchronous tasks) از چندوظیفهای مشارکتی (cooperative multitasking) استفاده میکنند. در این مدل، خود وظایف باید با یکدیگر همکاری کنند؛ یعنی خودشان اعلام کنند چه زمانی آمادهاند که کنترل را واگذار کنند—بدون دخالت سیستمعامل.
این یعنی کدی که داخل یک تسک اجرا میشود باید کمی تغییر کند تا چنین رفتاری ممکن شود.
مزیت این کار اضافی این است که دقیقاً میدانید تسکتان در کدام نقطه سوئیچ میشود و این باعث میشود تحلیل جریان اجرا راحتتر باشد.
در این مدل، یک تسک هرگز وسط اجرای یک دستور پایتون سوئیچ نمیشود، مگر اینکه آن دستور بهطور صریح علامتگذاری شده باشد (مثلاً با await) بعداً خواهید دید که همین ویژگی چطور میتواند بخشهایی از طراحی برنامه را سادهتر کند.
پاراللسازی (Parallelism) چیست؟
تا اینجا، ما به همزمانی (concurrency) روی یک پردازنده نگاه کردیم. اما همهی آن هستههای CPU که در لپتاپ جدیدتان وجود دارند چه میشوند؟ چگونه میتوان از آنها در Python استفاده کرد؟ پاسخ این است که باید از فرآیندهای جداگانه (separate processes) استفاده کنید!
یک فرآیند (process) را میتوان تقریباً بهعنوان یک برنامه کاملاً مستقل در نظر گرفت، هرچند از نظر فنی معمولاً بهعنوان مجموعهای از منابع تعریف میشود، شامل حافظه، فایل هندلها و موارد مشابه. یک راه ساده برای درک آن این است که هر فرآیند در مفسر Python مخصوص به خود اجرا میشود.
از آنجایی که اینها فرآیندهای جداگانه هستند، هر جریان منطقی (train of thought) در برنامهای که از multiprocessing استفاده میکند میتواند روی یک هسته CPU متفاوت اجرا شود. اجرای روی هستههای مختلف به این معنی است که آنها میتوانند واقعاً همزمان (simultaneously) اجرا شوند که بسیار عالی است. البته انجام این کار ممکن است با چند پیچیدگی همراه باشد، اما Python معمولاً در مدیریت این پیچیدگیها عملکرد قابل قبولی دارد.
نکته: هم Threading و هم Multiprocessing ابزارهایی هستن که بیشتر در «سطح پایین» (low-level) کار میکنن و برای ساختن ساختارهای همزمانی به کار میرن. توی عمل، خیلی وقتها میتونی بهجای اینکه مستقیم سراغ اینها بری، از concurrent.futures استفاده کنی؛ چون یک رابط سطح بالاتر (higher-level) در اختیارت میذاره و کار رو سادهتر میکنه.
کی از Concurrency استفاده میکنیم؟
Concurrency برای دو نوع مسئله خیلی مهم و اثرگذار است:
- I/O-Bound
- CPU-Bound
مسائل I/O-bound برنامه را کند میکنند چون برنامه مدام مجبور است برای ورودی/خروجی (I/O) از یک منبع خارجی صبر کند. این نوع مشکلات زمانی پیش میآید که برنامه با چیزهایی سروکار دارد که خیلی کندتر از CPU هستند.
چیزهایی که از CPU کندترند بیشمارند، اما خوشبختانه برنامه شما با همهٔ آنها درگیر نمیشود. رایجترین چیزهای کندی که برنامه با آنها برخورد میکند فایلسیستم (File System) و اتصالات شبکه (Network Connections) هستند.
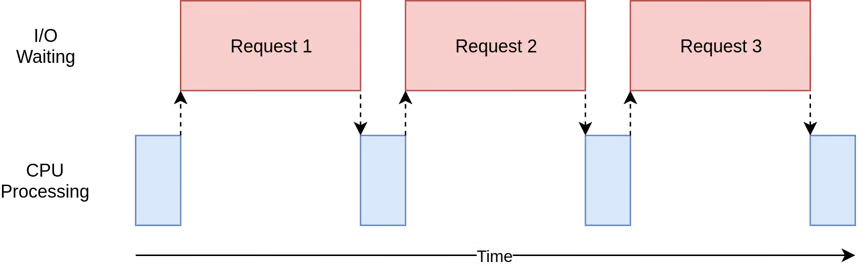
جعبههای آبی نشاندهنده زمانی هستند که برنامه شما در حال انجام کار واقعی است، و جعبههای قرمز زمان منتظر ماندن برای تکمیل یک عملیات I/O (waiting for an I/O operation to complete) را نشان میدهند. این دیاگرام به مقیاس نیست، چون درخواستها در اینترنت میتوانند چندین مرتبه کندتر از دستورهای CPU باشند، بنابراین برنامه شما ممکن است بیشتر زمان خود را صرف انتظار کند. این همان کاری است که مرورگر وب شما اکثر اوقات انجام میدهد.
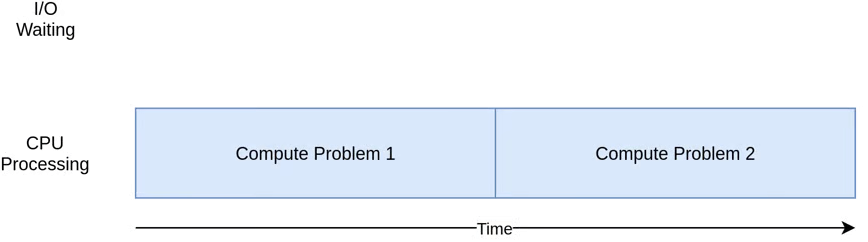
از سوی دیگر، کلاسهایی از برنامهها وجود دارند که محاسبات سنگینی انجام میدهند بدون اینکه با شبکه ارتباط داشته باشند یا به فایلها دسترسی پیدا کنند. این برنامهها CPU-bound هستند، چون محدودکننده سرعت برنامه، CPU است و نه شبکه یا فایلسیستم.
در اینجا یک دیاگرام مربوط به یک برنامه CPU-bound آورده شده است:
هنگامی که مثالهای بخش بعدی را بررسی میکنید، خواهید دید که اشکال مختلف همزمانی (Concurrency) بسته به اینکه برنامه I/O-bound باشد یا CPU-bound، عملکرد بهتری یا ضعیفتری دارند. اضافه کردن همزمانی به برنامه، کد اضافی و پیچیدگیهایی را به همراه دارد، بنابراین باید تصمیم بگیرید که آیا افزایش سرعت بالقوه ارزش صرف این تلاش اضافی را دارد یا خیر. تا پایان این آموزش، شما اطلاعات کافی برای گرفتن این تصمیم را خواهید داشت.
افزایش سرعت یک برنامه I/O-bound
در این بخش، تمرکز شما روی برنامههای I/O-bound و یک مشکل رایج خواهد بود: دانلود محتوا از طریق شبکه در این مثال، شما صفحات وب چند سایت را دانلود میکنید، اما این میتواند هر نوع ترافیک شبکه دیگری هم باشد. استفاده از صفحات وب فقط برای دیدن راحتتر و راهاندازی سادهتر مثال مناسب است.
نسخه غیرهمزمان (Non-Concurrent)
ابتدا با یک نسخه غیرهمزمان (non-concurrent) از این کار شروع میکنیم. توجه داشته باشید که این برنامه به کتابخانهٔ شخص ثالث Requests نیاز دارد. بنابراین ابتدا باید دستور زیر را در یک محیط مجازی فعال اجرا کنید:
(venv) $ python -m pip install requestsاین نسخه از برنامه شما هیچگونه همزمانی (concurrency) را استفاده نمیکند:
import time
import requests

def main():
    sites = [
        "https://www.jython.org",
        "http://olympus.realpython.org/dice",
    ] * 80
    start_time = time.perf_counter()
    download_all_sites(sites)
    duration = time.perf_counter() - start_time
    print(f"Downloaded {len(sites)} sites in {duration} seconds")

def download_all_sites(sites):
    with requests.Session() as session:
        for url in sites:
            download_site(url, session)

def download_site(url, session):
    with session.get(url) as response:
        print(f"Read {len(response.content)} bytes from {url}")

if __name__ == "__main__":
main()همانطور که مشاهده میکنید، این برنامه بسیار ساده است. وظیفهی آن تنها این است که محتوای تعدادی وبسایت را دانلود کند و اندازهی دادهی دریافتی از هر سایت را چاپ کند.
نکتهی قابل توجه این است که در این برنامه از یک شیء Session در کتابخانهی requests استفاده شده است. اگرچه میتوان مستقیماً از تابع requests.get() استفاده کرد، اما ایجاد یک Session این امکان را فراهم میکند که وضعیت داخلی درخواستها حفظ شود و اتصالهای شبکهای میان فراخوانیها بازاستفاده شوند. این موضوع معمولاً سرعت اجرای برنامه را به شکل محسوسی افزایش میدهد.
در تابع download_all_sites() یک سشن ساخته میشود و سپس برنامه به ترتیب روی فهرست آدرسها حرکت میکند و هر سایت را دانلود میکند. در پایان نیز مدتزمان اجرای کل عملیات اندازهگیری و چاپ میشود تا بتوان در مراحل بعد، هنگام استفاده از روشهای همزمانی (concurrency)، تأثیر بهبود عملکرد را بهصورت واضح مشاهده کرد.
نمودار پردازشی این نسخهی همگام (synchronous) تقریباً مشابه نمودار یک برنامهی I/O-Bound است؛ یعنی زمان زیادی صرف انتظار برای دریافت پاسخ از شبکه میشود و CPU بیشتر اوقات بیکار است.
نکته: حجم و سرعت ترافیک شبکه همیشه ثابت نیست و به عوامل مختلفی بستگی دارد که ممکن است از لحظهای به لحظهٔ دیگر تغییر کنند. بنابراین، طبیعی است که مدتزمان اجرای این تستها گاهی حتی تا دو برابر افزایش پیدا کند.
مزیتِ بزرگِ این نسخه از کد این است که ساده است. نوشتن و اشکالزدایی آن نسبتاً سریع انجام میشود و درک آن نیز راحتتر است. فقط یک جریان منطقی در کل برنامه وجود دارد؛ به همین دلیل، میتوان حدس زد قدم بعدی چیست و کد چگونه رفتار خواهد کرد.
اما مشکل اصلی این رویکرد این است که نسبت به روشهایی که در ادامه معرفی میشوند، سرعت بسیار کمتری دارد. نمونهای از خروجی نهایی این روش میتواند چیزی شبیه به این باشد:
Read 10966 from https://www.jython.org
Read 276 from http://olympus.realpython.org/dice
.
.
.
Downloaded 160 sites in 18.806305693000013 seconds
توجه داشته باشید که این نتایج میتوانند بسته به سرعت اتصال اینترنت، شلوغی شبکه و عوامل دیگر بهطور قابل توجهی متفاوت باشند. برای دقت بیشتر، بهتر است هر بنچمارک را چند بار تکرار کنید و سریعترین زمان اجرای هر آزمایش را ثبت کنید. به این ترتیب، تفاوت بین نسخههای مختلف برنامه شما همچنان قابل مشاهده خواهد بود.
کند بودن همیشه مشکل بزرگی نیست. اگر برنامه شما با نسخهی همگام (synchronous) فقط دو ثانیه طول میکشد و به ندرت اجرا میشود، احتمالاً اضافه کردن همزمانی (concurrency) ارزش تلاش اضافی را ندارد و میتوانید کار را همینجا متوقف کنید.
اما اگر برنامه شما اغلب اجرا شود یا ساعتها طول بکشد، آنوقت باید به سراغ همزمانی بروید و برنامه را با استفاده از Python Threads بازنویسی کنید.
نسخه چندریسمانی (Multi-Threaded Version)
همانطور که احتمالاً حدس زدهاید، نوشتن برنامهای که از multithreading استفاده میکند، نیازمند تلاش بیشتری است. با این حال، ممکن است شما را شگفتزده کند که برای موارد پایه، این تلاش اضافی چقدر کم است.
در ادامه، همان برنامه را میبینید وقتی از ماژولهای concurrent.futures و threading که پیشتر معرفی شدند، بهره میبریم:
import threading
import time
from concurrent.futures import ThreadPoolExecutor
import requests

thread_local = threading.local()

def main():
    sites = [
        "https://www.jython.org",
        "http://olympus.realpython.org/dice",
    ] * 80
    start_time = time.perf_counter()
    download_all_sites(sites)
    duration = time.perf_counter() - start_time
    print(f"Downloaded {len(sites)} sites in {duration} seconds")

def download_all_sites(sites):
    with ThreadPoolExecutor(max_workers=5) as executor:
        executor.map(download_site, sites)

def download_site(url):
    session = get_session_for_thread()
    with session.get(url) as response:
        print(f"Read {len(response.content)} bytes from {url}")

def get_session_for_thread():
    if not hasattr(thread_local, "session"):
        thread_local.session = requests.Session()
    return thread_local.session

if __name__ == "__main__":
    main()
ساختار کلی برنامه شما همان است، اما خطوط مشخصشده تغییراتی را نشان میدهند که لازم بوده اعمال کنید.
در خط ۲۰، یک نمونه از ThreadPoolExecutor ایجاد کردهاید تا مدیریت Threads را بر عهده بگیرد. در این مثال، شما بهطور صریح ۵ worker یا Thread درخواست دادهاید.
نکته: چگونه تعداد Threads در Thread Pool را انتخاب کنیم؟ پاسخ دقیق این است که تعداد مناسب ثابت نیست و بسته به نوع و پیچیدگی هر Task متفاوت است.
بهطور کلی، در مسائل I/O-bound محدود به تعداد هستههای CPU نیستید. در واقع، ایجاد صدها یا حتی هزاران Thread معمول است، به شرطی که بیشتر زمان منتظر دریافت داده باشند و مشغول انجام محاسبات سنگین نشوند. اما در نهایت، افزایش بیش از حد Threadها باعث کاهش بازدهی میشود، زیرا سوئیچ بین Threadها اضافهبار (overhead) ایجاد میکند.
همیشه توصیه میشود تجربه و آزمون و خطا داشته باشید. میتوانید با تغییر تعداد Threadها بازی کنید تا ببینید چگونه روی زمان کل اجرای برنامه تأثیر میگذارد.
ایجاد یک ThreadPoolExecutor ممکن است در ابتدا پیچیده به نظر برسد، اما اگر آن را تجزیه کنیم، در نهایت با سه بخش اصلی روبهرو میشویم:
- Thread
- Pool
- Executor
شما قبلاً با بخش Thread آشنا هستید؛ این همان جریان منطقی (train of thought) است که پیشتر توضیح داده شد. بخش Pool جایی است که کار جالب میشود. این شیء یک مجموعه از Threads ایجاد میکند که هرکدام میتوانند concurrently اجرا شوند. در نهایت، Executor بخشی است که کنترل میکند هر Thread در Pool چگونه و چه زمانی اجرا شود. Executor درخواستها را در Pool مدیریت و اجرا میکند.
نکته: استفاده از Thread Pool میتواند مفید باشد زمانی که منابع سیستم محدود هستند اما میخواهید چندین Task را مدیریت کنید. با ایجاد Threads از قبل و استفاده مجدد از آنها برای Taskهای بعدی، Pool باعث کاهش overhead ناشی از ایجاد و نابود کردن مکرر Threads میشود.
کتابخانه استاندارد Python، ThreadPoolExecutor را بهصورت یک context manager پیادهسازی کرده است، بنابراین میتوانید با استفاده از ساختار with مدیریت ایجاد و آزادسازی Pool از نمونههای threading.Thread را بهسادگی انجام دهید.
در این نسخه multi-threaded برنامه، شما اجازه میدهید executor بهجای اجرای دستی یک حلقه، تابع download_site() را فراخوانی کند. متد executor.map() در خط ۲۱ مسئول تقسیم کار بین Threads موجود است، بهطوری که هر Thread میتواند همزمان یک سایت متفاوت را پردازش کند. این متد دو آرگومان میگیرد:
- تابعی که روی هر داده اعمال شود، مثل آدرس یک سایت
- مجموعهای از دادهها که توسط آن تابع پردازش شوند
چون تابعی که به executor.map() داده میشود باید دقیقاً یک آرگومان بگیرد، شما download_site() را در خط ۲۳ تغییر دادید تا فقط یک URL بگیرد. اما حالا session object را چگونه دریافت کنیم؟
این یکی از مسائل جالب و چالشبرانگیز در threading است. چون سیستم عامل کنترل میکند چه زمانی یک Thread متوقف شود و Thread دیگری شروع به کار کند، هر دادهای که بین Threads به اشتراک گذاشته میشود باید thread-safe باشد تا از رفتار غیرمنتظره یا خراب شدن داده جلوگیری شود. متأسفانه requests.Session() thread-safe نیست؛ به این معنی که یک Thread ممکن است در حالی که Thread دیگری از همان session استفاده میکند، تداخل ایجاد کند.
چند استراتژی برای ایمنسازی دسترسی به دادهها وجود دارد. یکی از آنها استفاده از یک ساختار داده thread-safe است، مانند queue.Queue، multiprocessing.Queue یا asyncio.Queue. این اشیاء از ابزارهای سطح پایین مثل lock objects استفاده میکنند تا تضمین شود که در هر لحظه فقط یک Thread میتواند به یک بلوک کد یا بخش حافظه دسترسی پیدا کند. شما بهطور غیرمستقیم از این استراتژی از طریق ThreadPoolExecutor استفاده میکنید.
استراتژی دیگر استفاده از چیزی به نام thread-local storage است. وقتی در خط ۷ تابع threading.local() را فراخوانی میکنید، یک شیء ایجاد میکنید که شبیه یک متغیر سراسری است اما برای هر Thread جداگانه اختصاصی است. این کمی عجیب به نظر میرسد، اما شما تنها یک نمونه از آن ایجاد میکنید، نه یکی برای هر Thread. خود این شیء دسترسیهای مختلف از Threads متفاوت را به ویژگیهایش جدا میکند.
وقتی get_session_for_thread() فراخوانی میشود، session مربوط به Thread خاصی که در آن اجرا میشود بازگردانده میشود. بنابراین هر Thread برای اولین بار که get_session_for_thread() را صدا میزند، یک session ایجاد میکند و در تمامی فراخوانیهای بعدی در طول عمر خود از همان session استفاده میکند.
خب، حالا وقت آن است که نسخه multi-threaded برنامه خود را در عمل و تحت شرایط واقعی امتحان کنید:
Read 10966 bytes from https://www.jython.org
Read 277 bytes from http://olympus.realpython.org/dice
.
.
.
Downloaded 160 sites in 1.5620380730000534 seconds
سرعت آن بالاست! به خاطر داشته باشید که نسخه non-concurrent حتی در بهترین حالت بیش از ۱۴ ثانیه طول کشید.
این هم نمودار زمانبندی اجرای آن:
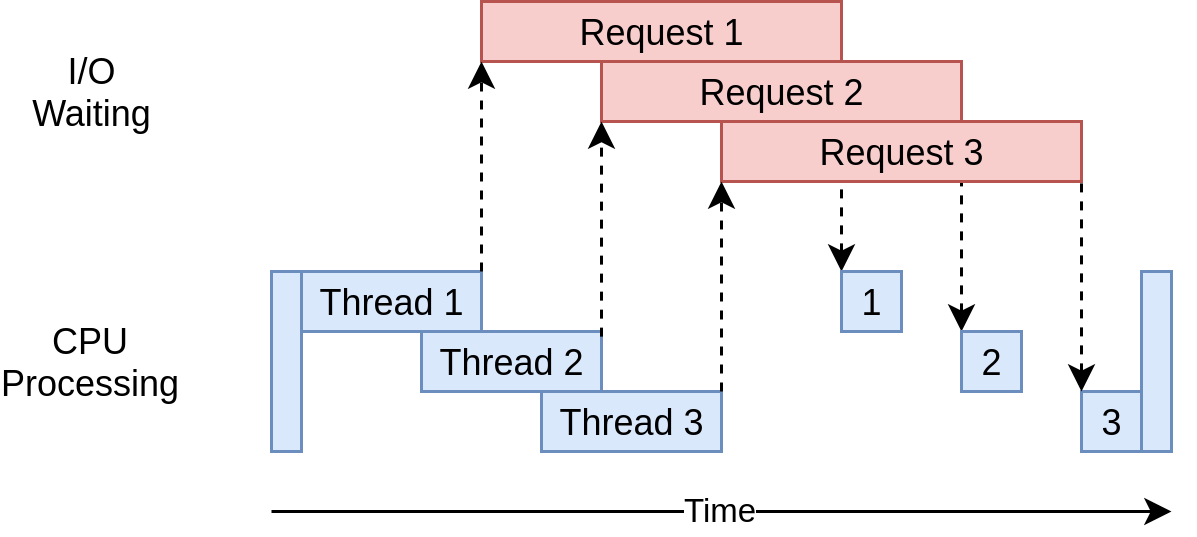
این برنامه از چند Thread استفاده میکند تا چندین درخواست به وبسایتها همزمان ارسال شوند. این کار باعث میشود که زمانهای انتظار همپوشانی پیدا کنند و نتیجه نهایی سریعتر حاصل شود. موفق شدیم! این همان هدف بود.
آیا نسخه multi-threaded مشکلاتی هم دارد؟ همانطور که از مثال مشخص است، برای پیادهسازی آن کمی کد بیشتر لازم است و باید دقیق فکر کنید که چه دادههایی بین Threads به اشتراک گذاشته میشوند.
Threads میتوانند به روشهایی با هم تعامل داشته باشند که ظریف و سخت قابل تشخیص هستند. این تعاملها میتوانند منجر به race condition شوند، که اغلب باعث بروز باگهای تصادفی و متناوب میشوند و پیدا کردنشان میتواند بسیار دشوار باشد.
نسخه ناهمزمان (Asynchronous Version)
اجرای Threads بهصورت همزمان باعث شد که زمان اجرای کل کد synchronous اصلی شما بهطور چشمگیری کاهش یابد. این خود قابل توجه است، اما میتوانید با استفاده از ماژول asyncio در Python که امکان asynchronous I/O را فراهم میکند، حتی بهتر از این عمل کنید.
پردازش Asynchronous یک مدل concurrency است که بهطور ویژه برای Taskهای I/O-bound مناسب است—از همین رو نام آن asyncio گذاشته شده است. این مدل با استفاده از event loop، عملیات non-blocking و coroutines، از اضافهبار context switching بین Threads جلوگیری میکند. شاید کمی تعجبآور باشد، اما کد asynchronous تنها با یک Thread میتواند بهصورت همزمان اجرا شود.
بهطور خلاصه، event loop کنترل میکند که هر asynchronous task چگونه و چه زمانی اجرا شود. همانطور که از نام آن پیداست، این حلقه بهصورت مداوم از میان Taskها عبور میکند و وضعیت آنها را مانیتور میکند. به محض اینکه یک Task در حال انتظار برای تکمیل یک عملیات I/O باشد، حلقه آن را متوقف میکند و فوراً به Task دیگری سوئیچ میکند. بالعکس، وقتی رویداد مورد انتظار رخ دهد، حلقه در تکرار بعدی Task متوقفشده را از سر میگیرد.
یک coroutine شبیه به یک Thread است، اما سبکتر و ارزانتر در توقف یا از سرگیری اجرا. همین ویژگی باعث میشود که بتوان تعداد زیادی coroutine نسبت به Thread ایجاد کرد بدون اینکه فشار قابل توجهی روی حافظه یا عملکرد وارد شود. این قابلیت به حل مشکل C10k کمک میکند، که مربوط به مدیریت ده هزار اتصال همزمان بهصورت کارآمد است. اما یک نکته وجود دارد:
اگر میخواهید از تمام مزایای برنامهنویسی asynchronous بهره ببرید، نمیتوانید در coroutineهای خود از فراخوانیهای blocking استفاده کنید. یک فراخوانی blocking همزمان (synchronous) است، یعنی تا زمانی که داده آماده نشده، اجازه اجرای کدهای دیگر را نمیدهد. در مقابل، یک فراخوانی non-blocking میتواند داوطلبانه کنترل را واگذار کند و منتظر اعلان آماده شدن داده بماند.
در Python، یک coroutine object با فراخوانی یک asynchronous function، که به آن coroutine function هم گفته میشود، ایجاد میکنید. این توابع با استفاده از دستور async def تعریف میشوند، نه دستور معمولی def. تنها در داخل بدنه یک تابع asynchronous است که میتوانید از کلیدواژه await استفاده کنید، که اجرای coroutine را متوقف میکند تا Task مورد انتظار کامل شود:
import asyncio

async def main():
    await asyncio.sleep(3.5)
در این مثال، شما main() را بهعنوان یک asynchronous function تعریف کردهاید که هنگام فراخوانی، بهصورت ضمنی یک coroutine object برمیگرداند. با استفاده از کلیدواژه await، coroutine شما یک فراخوانی non-blocking به asyncio.sleep() انجام میدهد و تأخیری معادل سه و نیم ثانیه شبیهسازی میکند. در حالی که تابع main() منتظر رخداد پایان تأخیر است، سایر Taskها میتوانند بهصورت همزمان (concurrently) اجرا شوند.
نکته: برای اجرای کد نمونه بالا، باید یا فراخوانی main() را در asyncio.run() قرار دهید یا در محیط asyncio REPL از await main() استفاده کنید.
حالا که درک پایهای از asynchronous I/O پیدا کردهاید، میتوانید نسخه asynchronous کد نمونه را بررسی کرده و بفهمید چگونه کار میکند. با این حال، چون کتابخانه Requests که تا اینجا استفاده کردهاید blocking است، اکنون باید به یک جایگزین non-blocking مانند aiohttp سوئیچ کنید که برای استفاده با Python’s asyncio طراحی شده است.
(venv) $ python -m pip install aiohttpپس از نصب این کتابخانه در virtual environment خود، میتوانید از آن در نسخه asynchronous کد استفاده کنید:
import asyncio
import time
import aiohttp

async def main():
    sites = [
        "https://www.jython.org",
        "http://olympus.realpython.org/dice",
    ] * 80
    start_time = time.perf_counter()
    await download_all_sites(sites)
    duration = time.perf_counter() - start_time
    print(f"Downloaded {len(sites)} sites in {duration} seconds")

async def download_all_sites(sites):
    async with aiohttp.ClientSession() as session:
        tasks = [download_site(url, session) for url in sites]
        await asyncio.gather(*tasks, return_exceptions=True)

async def download_site(url, session):
    async with session.get(url) as response:
        print(f"Read {len(await response.read())} bytes from {url}")

if __name__ == "__main__":
    asyncio.run(main())
این نسخه بهطرز چشمگیری شبیه نسخه synchronous بهنظر میرسد، که یکی دیگر از مزایای asyncio است. با این حال، این ویژگی دو لبه دارد: اگرچه میتوان گفت کد concurrent شما را نسبت به نسخه multi-threaded راحتتر قابل درک میکند، اما وقتی وارد سناریوهای پیچیدهتر میشوید، کار با asyncio اصلاً ساده نیست.
در مقایسه با نسخه non-concurrent، مهمترین تفاوتها به شرح زیر است:
- خط 1: کتابخانه asyncio از کتابخانه استاندارد Python وارد شده است. این برای اجرای تابع asynchronous main() در خط 26 ضروری است.
- خط 4: کتابخانه ثالث aiohttp وارد شده است که قبلاً نصب شده و جایگزین Requests در مثالهای قبلی میشود.
- خطوط 6، 16 و 21: توابع معمولی شما به توابع asynchronous تبدیل شدهاند با اضافه کردن کلیدواژه async به تعریف آنها.
- خط 12: کلیدواژه await به download_all_sites() اضافه شده تا coroutine object بازگشتی انتظار کشیده شود. این باعث توقف موقت تابع main() تا پایان دانلود همه سایتها میشود.
- خطوط 17 و 22: از دستور async with برای ایجاد asynchronous context manager برای شیء session و response استفاده شده است.
- خط 18: با استفاده از list comprehension لیستی از tasks ایجاد شده، که هر کدام یک coroutine object بازگشتی از download_site() هستند. توجه داشته باشید که هر coroutine بهصورت جداگانه await نمیشود، چون این کار باعث اجرای متوالی آنها میشد.
- خط 19: از asyncio.gather() برای اجرای همه tasks بهصورت concurrent استفاده شده، که امکان دانلود همزمان چندین سایت را فراهم میکند.
- خط 23: اجرای درخواست HTTP GET مربوط به session قبل از چاپ تعداد بایتهای دریافتشده await میشود تا از کامل شدن آن مطمئن شویم.
میتوانید session را بین تمام tasks به اشتراک بگذارید، بنابراین اینجا session بهصورت یک context manager ایجاد شده است. Tasks میتوانند session را به اشتراک بگذارند چون همه روی یک thread اجرا میشوند و هیچ task نمیتواند دیگری را در حالی که session در وضعیت نامناسبی است، قطع کند.
یک تغییر کوچک اما مهم هم در جزئیات نهفته است. به یاد دارید که درباره تعداد بهینه threads صحبت کردیم؟ در مثال multi-threaded مشخص نبود تعداد بهینه threads چقدر است.
یکی از مزایای asyncio این است که مقیاسپذیری بسیار بهتری نسبت به threading یا concurrent.futures دارد. هر task منابع و زمان بسیار کمتری نسبت به یک thread مصرف میکند، بنابراین ایجاد و اجرای تعداد بیشتری از آنها به خوبی کار میکند. در این مثال، برای هر سایت یک task جداگانه ایجاد شده که عملکرد خوبی دارد.
و باید گفت که سرعت آن واقعاً بالاست. نسخه asynchronous از همه سریعتر است و اختلاف قابل توجهی با بقیه دارد:
اجرای این نسخه کمتر از نیم ثانیه طول کشید، به این معنا که این کد هفت برابر سریعتر از نسخه چندنخی (multi-threaded) و بیش از سی برابر سریعتر از نسخه غیرهمزمان (non-concurrent) است!
توجه: در نسخه synchronous، شما لیستی از سایتها را به ترتیب مشخص مرور کرده و محتوای آنها را دانلود میکردید. در نسخه multi-threaded، کنترل زمانبندی tasks را به سیستمعامل واگذار کردید، بنابراین ترتیب نهایی دانلودها بهنظر تصادفی میآید. در نسخه asynchronous ممکن است برخی tasks بهصورت خوشهای تمام شوند، اما بهطور کلی غیرقابل پیشبینی است، چرا که شرایط شبکه دائم تغییر میکند.
نمودار زمانبندی اجرای برنامه شباهت زیادی به مثال multi-threaded دارد. تنها تفاوت این است که تمام درخواستهای I/O توسط یک thread واحد انجام میشوند.
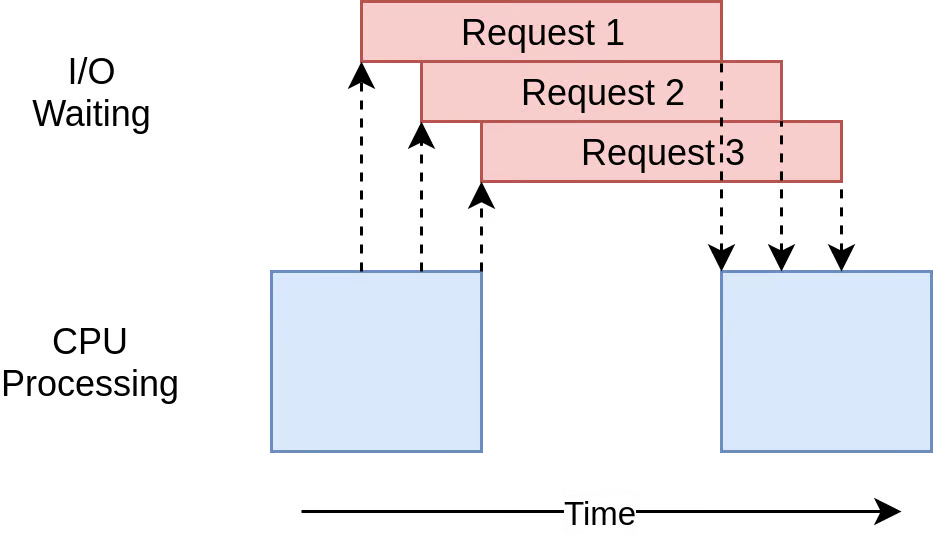
یک نکته رایج این است که اضافه کردن async و await در مکانهای مناسب، خودش پیچیدگی اضافه ایجاد میکند. تا حدی درست است، اما روی دیگر سکه این است که مجبور میشوید دقیقاً فکر کنید که هر task چه زمانی معلق میشود، و این میتواند به طراحی بهتر برنامه کمک کند. مسئله مقیاسپذیری هم اهمیت زیادی دارد. اجرای نسخه multi-threaded با یک thread برای هر سایت بهطور قابل توجهی کندتر از اجرای آن با چند thread محدود است. اما اجرای مثال asyncio با صدها task اصلاً سرعت را کم نمیکند. چند مشکل هم در asyncio وجود دارد. برای بهرهبرداری کامل از آن، نیاز به نسخههای asynchronous از کتابخانهها دارید. اگر فقط از Requests برای دانلود سایتها استفاده میکردید، برنامه بسیار کندتر میشد، زیرا Requests طراحی نشده تا به event loop اطلاع دهد که در حالت بلاک است. با گذر زمان و پذیرش بیشتر کتابخانهها برای asyncio، این مشکل اهمیت کمتری پیدا کرده است. یک مشکل ظریفتر هم این است که تمام مزایای cooperative multitasking از بین میرود اگر یکی از taskها همکاری نکند. یک اشتباه کوچک میتواند باعث شود یک task طولانی اجرا شود و پردازنده را برای دیگر taskها که نیاز به اجرا دارند، محروم کند. هیچ راهی برای event loop وجود ندارد تا در این شرایط کنترل را بازپس بگیرد. با این پیشزمینه، میتوانید به رویکردی کاملاً متفاوت برای concurrency با استفاده از چند process حرکت کنید.
نسخه مبتنی بر Process
تا اینجا، تمام مثالهای concurrency در این آموزش فقط روی یک CPU یا یک core اجرا میشدند. دلیل این محدودیت به طراحی فعلی CPython و چیزی به نام Global Interpreter Lock یا GIL برمیگردد.
این آموزش به جزئیات نحوه عملکرد GIL نمیپردازد. فعلاً کافی است بدانید که نسخههای synchronous، multi-threaded و asynchronous این مثال همه روی یک CPU اجرا میشوند.
ماژول multiprocessing، همراه با wrapperهای مربوطه در concurrent.futures، طراحی شده تا این محدودیت را بردارد و کد شما را روی چند CPU اجرا کند. به طور کلی، این کار با ایجاد یک نمونه جدید از Python interpreter برای هر CPU و واگذار کردن بخشی از برنامه به آن انجام میشود.
همانطور که انتظار میرود، راهاندازی یک Python interpreter جداگانه به اندازه ایجاد یک thread جدید در interpreter فعلی سریع نیست. این یک عملیات سنگین است و محدودیتها و پیچیدگیهایی دارد، اما برای مسئله مناسب میتواند تفاوت بزرگی ایجاد کند.
«برخلاف روشهای قبلی، استفاده از multiprocessing این امکان را میدهد که از تمام هستههای پردازندهی کامپیوتر جدیدتان بهطور کامل استفاده کنید. در ادامه نمونهکد آن آمده است.»
import atexit
import multiprocessing
import time
from concurrent.futures import ProcessPoolExecutor
import requests

session: requests.Session

def main():
    sites = [
        "https://www.jython.org",
        "http://olympus.realpython.org/dice",
    ] * 80
    start_time = time.perf_counter()
    download_all_sites(sites)
    duration = time.perf_counter() - start_time
    print(f"Downloaded {len(sites)} sites in {duration} seconds")

def download_all_sites(sites):
    with ProcessPoolExecutor(initializer=init_process) as executor:
        executor.map(download_site, sites)

def download_site(url):
    with session.get(url) as response:
        name = multiprocessing.current_process().name
        print(f"{name}:Read {len(response.content)} bytes from {url}")

def init_process():
    global session
    session = requests.Session()
    atexit.register(session.close)

if __name__ == "__main__":
    main()
این نسخه درواقع شباهت زیادی به مثال multi-threaded دارد، چون بهجای استفادهٔ مستقیم از multiprocessing از همان abstraction آشنای concurrent.futures استفاده میکنید. حالا یک مرور سریع کنیم ببینیم این کد دقیقاً چه کارهایی برای شما انجام میدهد:
خط ۸ از type hintها برای اعلام یک متغیر global استفاده میکند که قرار است شیء session را نگه دارد. توجه داشته باش که این کار در واقع مقدار متغیر را تعریف نمیکند.
خط ۲۱ بهجای ThreadPoolExecutor از ProcessPoolExecutor در concurrent.futures استفاده میکند و تابع init_process() را که پایینتر تعریف شده، به آن پاس میدهد.
خطوط ۲۹ تا ۳۲ یک تابع initializer سفارشی تعریف میکنند که هر پردازش مدت کوتاهی پس از شروع، آن را فراخوانی میکند. این تابع تضمین میکند که هر پردازش، session مخصوص خودش را مقداردهی اولیه کند.
خط ۳۲ یک تابع cleanup را با atexit ثبت میکند تا مطمئن شود زمانی که پردازش متوقف شد، session بهدرستی بسته میشود. این کار به جلوگیری از نشت حافظه کمک میکند.
آنچه اینجا اتفاق میافتد این است که pool تعدادی پردازش مجزا از مفسر پایتون ایجاد میکند و هرکدام از آنها تابع مشخصشده را روی بخشی از آیتمهای iterable اجرا میکنند؛ که در مورد تو، همان لیست سایتهاست. ارتباط بین پردازش اصلی و پردازشهای دیگر بهصورت خودکار مدیریت میشود.
خطی که یک نمونه از pool ایجاد میکند قابل توجه است. ابتدا اینکه مشخص نکرده چند پردازش باید در pool ساخته شود، هرچند این یک پارامتر اختیاری است. بهصورت پیشفرض، تعداد CPUهای سیستم را تشخیص میدهد و همان تعداد پردازش میسازد. این معمولاً بهترین انتخاب است و در مورد تو هم همینطور است.
برای یک مسئله I/O-bound، افزایش تعداد پردازشها باعث سریعتر شدن کار نمیشود. در واقع باعث کندی میشود، چون هزینه ایجاد و نابود کردن آن پردازشهای اضافه بیشتر از سود انجام موازی درخواستهای I/O است.
نکته: وقتی لازم باشد دادهها بین پردازشها (processes) منتقل شوند، این کار نیازمند ارتباط بینپردازشی (IPC) و سریالسازی دادهها است که هزینه اجرای برنامه را بالا میبرد. علاوه بر این، سریالسازی همیشه ممکن نیست، چون Python از ماژول pickle استفاده میکند که فقط از تعداد محدودی نوع داده پشتیبانی میکند.
سپس به بخش initializer آن فراخوانی میرسیم. به یاد داشته باشید که هر پردازش در این pool فضای حافظه مخصوص به خود را دارد. این یعنی نمیتوانند بهراحتی چیزهایی مثل یک شیء Session را به اشتراک بگذارند. شما نمیخواهید هر بار که تابع فراخوانی میشود یک Session جدید ایجاد کنید---بلکه میخواهید برای هر پردازش یک نمونه بسازید.
پارامتر initializer function دقیقاً برای همین مورد طراحی شده است. هیچ راهی برای بازگرداندن مقداری از initializer به تابع download_site() وجود ندارد، اما میتوانید یک متغیر سراسری (global) را مقداردهی کنید تا Session واحد هر پردازش را نگه دارد. از آنجایی که هر پردازش فضای حافظهٔ خودش را دارد، متغیر سراسری هر کدام متفاوت خواهد بود.
باقی کد تقریباً مشابه آن چیزی است که قبلی دیدید. نسخه مبتنی بر process نیاز به کمی تنظیمات اضافی دارد و متغیر سراسری session کمی عجیب به نظر میرسد. باید زمانی را صرف فکر کردن دربارهٔ این کنید که هر پردازش به کدام متغیرها دسترسی خواهد داشت.
با اینکه این نسخه تمام قدرت پردازندهی کامپیوتر شما را به کار میگیرد، عملکرد نهایی بهطرز غیرمنتظرهای ضعیف است:
ForkProcess-3:Read 10966 bytes from https://www.jython.org
ForkProcess-4:Read 277 bytes from http://olympus.realpython.org/dice
.
.
.
Downloaded 160 sites in 4.228125616999932 seconds
روی یک کامپیوتری که چهار هستهی CPU دارد، این نسخه حدود چهار برابر سریعتر از نسخهی synchronous اجرا میشود. با این حال، هنوز کمی کندتر از نسخهی multi-threaded و بسیار کندتر از نسخهی asynchronous است.
نمودار زمانبندی اجرای این کد به شکل زیر است:
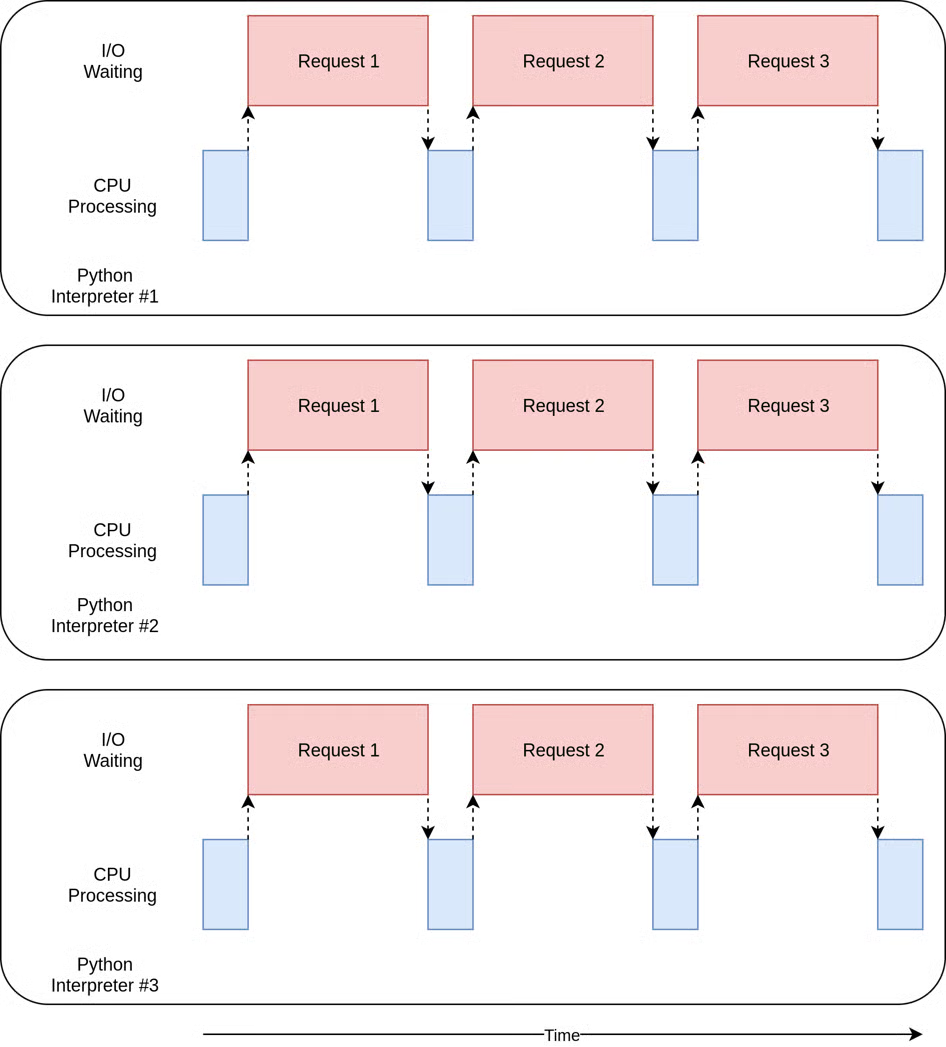
چند پردازش جداگانه بهطور همزمان در حال اجرا هستند. نمودارهای مربوط به هر یک از این پردازشها شبیه نسخهی غیرهمزمانی هستند که در ابتدای این آموزش مشاهده کردید.
مسائل I/O-bound دلیل اصلی وجود multiprocessing نیستند. وقتی به بخش بعدی و مثالهای CPU-bound بروید، بیشتر متوجه کاربرد آن خواهید شد.
افزایش سرعت یک برنامهی CPU-bound
تا اینجا همهی مثالها به مسائل I/O-bound مربوط بودند. حالا میخواهیم به یک مسئلهی CPU-bound نگاه کنیم. همانطور که قبلاً یاد گرفتید، یک مسئلهی I/O-bound بیشتر وقت خود را صرف انتظار برای تکمیل عملیات خارجی میکند، مثل تماسهای شبکه. در مقابل، یک مسئلهی CPU-bound تعداد عملیات I/O کمتری دارد و زمان کل اجرای آن به سرعت پردازش دادههای مورد نیاز توسط CPU بستگی دارد.
برای این مثال، از یک تابع نسبتاً ساده و طنزگونه استفاده میکنیم تا قطعه کدی بسازیم که اجرای آن روی CPU زمان زیادی ببرد. این تابع، عدد nام دنباله فیبوناچی را با روش بازگشتی (recursive) محاسبه میکند:
>>> def fib(n):
...     return n if n < 2 else fib(n - 2) + fib(n - 1)
...
>>> for n in range(1, 11):
...     print(f"fib({n:>2}) = {fib(n):,}")
...
fib( 1) = 1
fib( 2) = 1
fib( 3) = 2
fib( 4) = 3
fib( 5) = 5
fib( 6) = 8
fib( 7) = 13
fib( 8) = 21
fib( 9) = 34
fib(10) = 55
توجه کنید که چگونه مقادیر بهسرعت بزرگ میشوند وقتی تابع اعداد بالاتر فیبوناچی را محاسبه میکند. ماهیت بازگشتی (recursive) این پیادهسازی باعث میشود تعداد زیادی محاسبه تکراری از همان اعداد انجام شود و در نتیجه زمان پردازش قابل توجهی نیاز باشد. به همین دلیل این مثال بهخوبی نشاندهنده یک کار CPU-bound است. به خاطر داشته باشید که این فقط یک نمونه جایگزین است برای کدی که واقعاً کاری مفید انجام میدهد و نیازمند پردازش طولانی است، مثل محاسبه ریشههای معادلات یا مرتبسازی یک ساختار داده بزرگ.
نسخه همزمان (Synchronous Version)
ابتدا میتوانید نسخه بدون concurrency این مثال را بررسی کنید:
import time

def main():
    start_time = time.perf_counter()
    for _ in range(20):
        fib(35)
    duration = time.perf_counter() - start_time
    print(f"Computed in {duration} seconds")

def fib(n):
    return n if n < 2 else fib(n - 2) + fib(n - 1)

if __name__ == "__main__":
    main()
این کد تابع fib(35) را بیست بار در یک حلقه فراخوانی میکند. به دلیل بازگشتی (recursive) بودن پیادهسازی، تابع صدها میلیون بار خودش را فراخوانی میکند! تمام این محاسبات روی یک Thread در یک Process و روی یک CPU انجام میشود.
نمودار زمانبندی اجرای این کد به این شکل است:
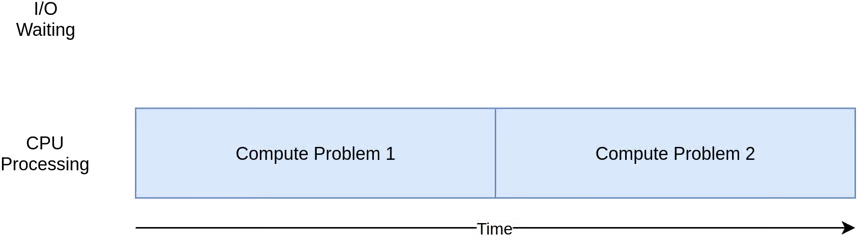
برخلاف مثالهای I/O-bound، مثالهای CPU-bound معمولاً زمان اجرای نسبتاً ثابتی دارند. اجرای این مثال روی همان دستگاه قبلی حدود سی و پنج ثانیه طول میکشد:
Computed in 31.87804803200015 secondsواضح است که میتوان بهتر از این عمل کرد. به هر حال، همه چیز روی یک CPU و بدون concurrency اجرا میشود. در مرحله بعد، خواهید دید چگونه میتوان این عملکرد را بهبود داد.
نسخه Multi-Threaded
فکر میکنید بازنویسی این کد با استفاده از threads یا tasks غیرهمزمان چقدر سرعت را افزایش میدهد؟ اگر پاسختان «هیچ» بود، یک شیرینی به خودتان بدهید. اگر پاسختان «کندتر میشود» بود، دو شیرینی!
علت این است: در مثالهای I/O-bound قبلی، بخش زیادی از زمان صرف انتظار برای اتمام عملیات کند میشد. threads و tasks غیرهمزمان این زمانها را با هم همپوشانی دادند تا به جای انجام آنها به صورت متوالی، همزمان پیش بروند.
اما در مسائل CPU-bound، هیچ انتظاری وجود ندارد. CPU تمام تلاش خود را میکند تا مسئله را حل کند. در پایتون، هم threads و هم tasks غیرهمزمان روی همان CPU و همان process اجرا میشوند. این یعنی یک CPU همه کارهای نسخه غیرهمزمان را انجام میدهد و علاوه بر آن، کار اضافه مربوط به راهاندازی threads یا tasks را هم باید تحمل کند.
نسخه multi-threaded مسئله CPU-bound شما به این شکل است:
import time
from concurrent.futures import ThreadPoolExecutor

def main():
    start_time = time.perf_counter()
    with ThreadPoolExecutor(max_workers=5) as executor:
        executor.map(fib, [35] * 20)
    duration = time.perf_counter() - start_time
    print(f"Computed in {duration} seconds")

def fib(n):
    return n if n < 2 else fib(n - 2) + fib(n - 1)

if __name__ == "__main__":
    main()
تغییرات این نسخه نسبت به نسخه غیر همزمان (non-concurrent) خیلی کم بود. بعد از وارد کردن concurrent.futures، به جای حلقه زدن روی اعداد، یک thread pool ایجاد کرده و با استفاده از متد .map() اعداد را به threadهای آزاد میفرستید تا محاسبات را انجام دهند.
این دقیقا همان کاری است که برای نسخه multi-threaded مسئله I/O-bound انجام دادید، با این تفاوت که اینجا نیازی به مدیریت شیء Session ندارید.
در ادامه، نمونه خروجیای که ممکن است هنگام اجرای این کد ببینید آمده است:
(venv) $ python cpu_threads.py
Computed in 39.86391678399741 seconds
بدیهی است که اجرای این نسخه کمی بیشتر از نسخه همزمان (synchronous) طول میکشد.
تا این مرحله، باید دید کلی از عملکرد نسخه asynchronous در مسائل CPU-bound داشته باشید. اما برای بررسی کامل، حالا آن را با سایر نسخهها مقایسه خواهیم کرد.
نسخه Asynchronous
برای پیادهسازی نسخه asynchronous این مسئله CPU-bound، باید توابع خود را به coroutine تبدیل کنید با استفاده از async def و منتظر (await) مقدار بازگشتی آنها بمانید:
import asyncio
import time

async def main():
    start_time = time.perf_counter()
    tasks = [fib(35) for _ in range(20)]
    await asyncio.gather(*tasks, return_exceptions=True)
    duration = time.perf_counter() - start_time
    print(f"Computed in {duration} seconds")

async def fib(n):
    return n if n < 2 else await fib(n - 2) + await fib(n - 1)

if __name__ == "__main__":
    asyncio.run(main())
شما بیست task ایجاد میکنید و آنها را به asyncio.gather() میدهید تا coroutines مربوطه به صورت concurrent اجرا شوند. با این حال، آنها عملاً به صورت متوالی اجرا میشوند، چون هر کدام تا پایان اجرای قبلی، اجرای خود را بلوک میکند.
وقتی این کد اجرا شود، بیش از دو برابر نسخهی synchronous اصلی طول میکشد و حتی از نسخهی multi-threaded نیز کندتر است.
(venv) $ python cpu_asyncio.py
Computed in 86.50057094899967 seconds
طنز ماجرا این است که روش asynchronous برای یک مسئله CPU-bound کندترین گزینه است، در حالی که برای مسئله I/O-bound سریعترین بود. چون در اینجا عملیاتی برای I/O وجود ندارد و چیزی برای انتظار کشیدن نیست، سربار event loop و تغییر context در هر دستور await باعث میشود زمان اجرای کل برنامه بهطور محسوسی افزایش یابد. در پایتون، برای بهبود کارایی یک CPU-bound task مانند این مثال، باید از یک مدل همزمانی (concurrency) جایگزین استفاده کنید. در ادامه، به بررسی دقیقتر این روش میپردازیم.
نسخه مبتنی بر Process
بالاخره به بخشی رسیدیم که multiprocessing واقعاً خودش را نشان میدهد. بر خلاف سایر مدلهای concurrency، parallelism مبتنی بر process بهطور ویژه برای تقسیم بارهای سنگین CPU بین چندین پردازنده طراحی شده است. نمونه کدی که این کار را انجام میدهد به شکل زیر است:
import time
from concurrent.futures import ProcessPoolExecutor

def fib(n):
    return n if n < 2 else fib(n - 2) + fib(n - 1)

def main():
    start_time = time.perf_counter()
    with ProcessPoolExecutor() as executor:
        executor.map(fib, [35] * 20)
    duration = time.perf_counter() - start_time
    print(f"Computed in {duration} seconds")

if __name__ == "__main__":
    main()
این نسخه تقریباً مشابه نسخه multi-threaded مسئله فیبوناچی است. در واقع فقط دو خط کد را تغییر دادهاید! به جای استفاده از ThreadPoolExecutor، آن را با ProcessPoolExecutor جایگزین کردهاید.
همانطور که قبلاً اشاره شد، پارامتر اختیاری max_workers در سازندهی pool ارزش توجه دارد. میتوانید از آن برای تعیین تعداد processهایی که میخواهید ایجاد و مدیریت شوند استفاده کنید. به طور پیشفرض، این مقدار تعداد CPUهای سیستم شما را تشخیص داده و برای هر کدام یک process ایجاد میکند. این روش برای مثال ساده شما عالی است، اما در محیط تولید ممکن است بخواهید کنترل بیشتری داشته باشید.
این نسخه حدود ده ثانیه طول میکشد که کمتر از یک سوم زمان اجرای نسخهی غیرهمزمان (non-concurrent) اولیه است.
(venv) $ python cpu_processes.py
Computed in 10.020093858998735 seconds
این عملکرد بهمراتب بهتر از سایر روشها است و بهطور قابل توجهی آن را به بهترین گزینه برای این نوع کار تبدیل میکند.
نمودار زمانبندی اجرای این نسخه به شکل زیر است:
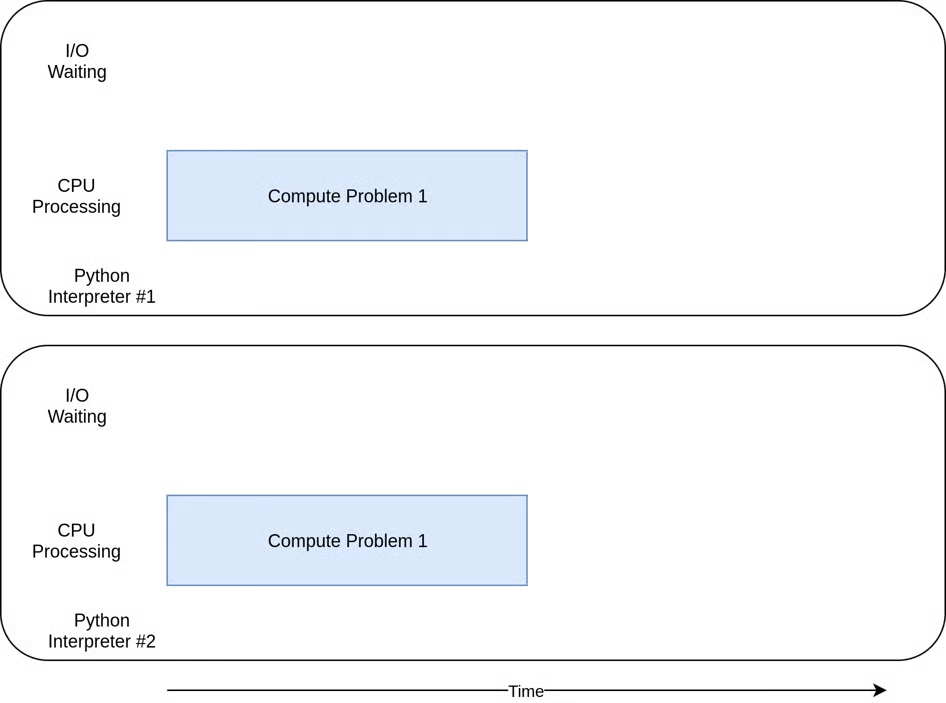
هر تسک بهصورت همزمان روی هستههای جداگانه CPU اجرا میشود و امکان اجرای parallel فراهم میشود.
با این حال، استفاده از multiprocessing معایبی دارد که در یک مثال ساده مثل این زیاد به چشم نمیآید. مثلاً تقسیم مسئله به بخشهایی که هر پردازنده بتواند بهطور مستقل روی آنها کار کند، گاهی میتواند دشوار باشد.
همچنین، بسیاری از راهحلها نیازمند تبادل اطلاعات بیشتر بین پردازشها هستند که میتواند پیچیدگی برنامه را افزایش دهد---چیزی که در یک برنامه غیرهمزمان (non-concurrent) لازم نیست.
تصمیمگیری برای استفاده از Concurrency
تا زمانی که یک مشکل عملکرد مشخص نداشته باشید، استفاده از Concurrency را به تعویق بیندازید و پس از شناسایی مشکل، نوع Concurrency مورد نیاز خود را مشخص کنید. همانطور که Donald Knuth گفته است: «بهینهسازی زودهنگام ریشه تمام بدیها (یا حداقل بیشتر آنها) در برنامهنویسی است.»
پس از تصمیم برای بهینهسازی برنامه، گام بعدی این است که مشخص کنید برنامه شما I/O-bound است یا CPU-bound. برنامههای I/O-bound بخش زیادی از زمان خود را صرف انتظار برای وقوع یک رویداد میکنند، در حالی که برنامههای CPU-bound بیشتر زمان خود را صرف پردازش داده یا محاسبه سریع میکنند.
همانطور که دیدید، مسائل CPU-bound در Python تنها با استفاده از Concurrency مبتنی بر Process بهبود مییابند. Multithreading و asynchronous I/O برای این نوع مسائل کمکی نمیکنند.
برای مسائل I/O-bound، یک قاعده کلی در جامعه Python وجود دارد: «وقتی امکان دارد از asyncio استفاده کنید، در غیر این صورت از threading یا concurrent.futures بهره ببرید.» asyncio معمولاً بهترین افزایش سرعت را برای این نوع برنامهها ارائه میدهد، اما گاهی نیاز به کتابخانههای حیاتی دارید که هنوز برای asyncio پورت نشدهاند. به یاد داشته باشید که هر تسکی که کنترل خود را به event loop تحویل ندهد، همه تسکهای دیگر را مسدود خواهد کرد.
نتیجه گیری
شما با مفهوم Concurrency در Python آشنا شدید و فهمیدید که چگونه میتواند عملکرد و پاسخگویی برنامههایتان را بهبود بخشد. مدلهای مختلف Concurrency، از جمله threading، asynchronous tasks و multiprocessing را بررسی کردید. با استفاده از مثالهای عملی، درک کردید که چه زمانی و چگونه میتوان این مدلها را پیادهسازی کرد تا هم برای تسکهای I/O-bound و هم CPU-bound بهینهسازی انجام شود.
درک Concurrency برای توسعهدهندگان Python که میخواهند کارایی برنامهها را افزایش دهند، حیاتی است، بهویژه در سناریوهایی که شامل عملیات سنگین I/O یا محاسباتی هستند. با انتخاب مدل مناسب Concurrency، میتوانید زمان اجرا را به طور چشمگیری کاهش داده و منابع سیستم موجود را به بهترین شکل استفاده کنید.
با این مهارتها، اکنون توانایی تحلیل برنامههای Python خود و استفاده مؤثر از Concurrency برای رفع گلوگاههای عملکرد را دارید. چه در حال بهینهسازی یک وباسکرپر باشید و چه یک خط پردازش داده، میتوانید با اطمینان بهترین مدل Concurrency را برای بهبود کارایی برنامه خود انتخاب کنید.